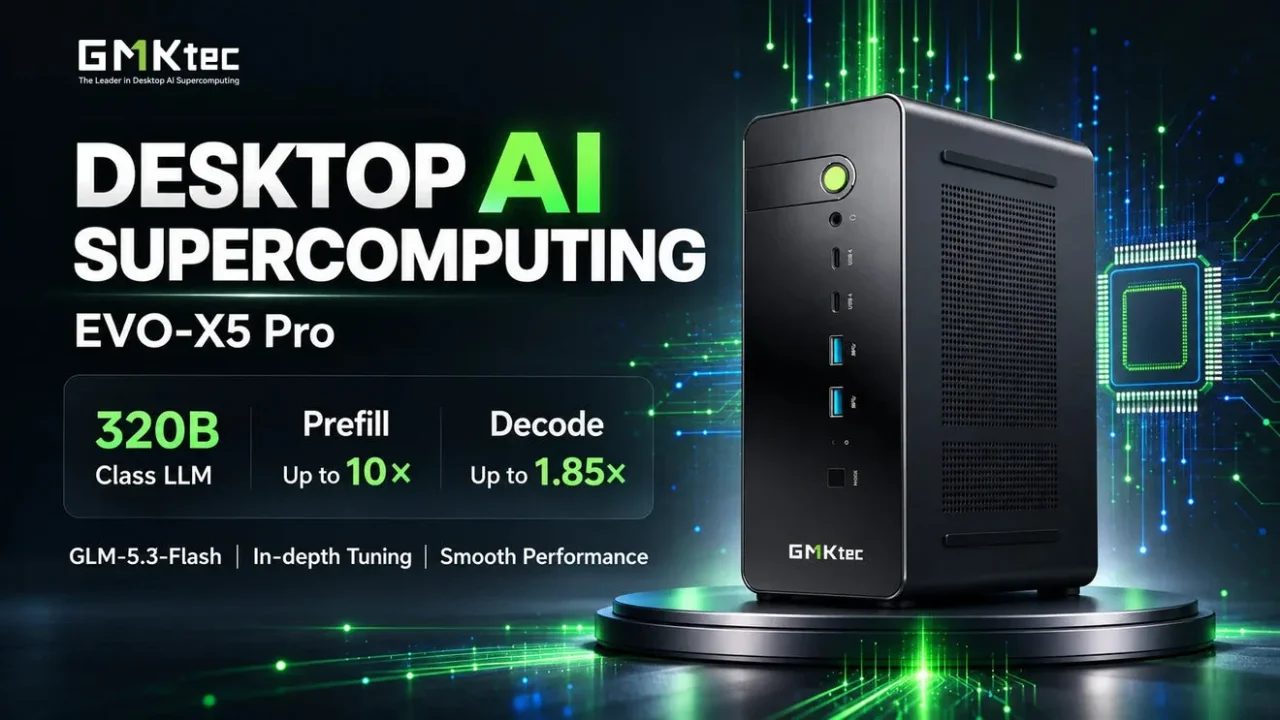
GMKtecは10月29日、デスクトップAIスーパーコンピューター『GMKtec EVO-X5 Pro』で、320Bクラスの大規模言語モデル『GLM-5.3-Flash』の推論性能を改善したと発表しました。同社の社内テストでは、Prefill性能が社内テストの基準構成と比べて約10倍、Decode性能が約1.85倍に向上しました。
同社の開発チームは、『GLM-5.3-Flash』の実行環境に対し、推論処理の各段階を対象とした最適化を実施しました。
Prefillは、入力されたプロンプトを処理し、応答の生成を始める前の段階です。Decodeは、入力の処理が終わったあとにトークンを順次生成して回答を出力する段階です。
192GBのユニファイドメモリに対応するハードウェア
『GMKtec EVO-X5 Pro』は、AMD Ryzen AI Max+ PRO 495プロセッサを搭載しています。グラフィックスはAMD Radeon 8065Sで、最大192GBのユニファイドメモリに対応します。
CPUと内蔵GPUがメモリを共有する構成です。同社は、大規模なモデルや長いコンテキストを扱うAIワークロードに対応するための基盤になるとしています。
クラウドサービスだけに依存せず、デスクトップ上で大規模言語モデルを実行・検証する環境を構築できます。
1,024トークンから約500Kトークンまでのテスト結果
同社は最適化した実行環境を、1,024トークンから最大499,712トークンまでの入力長でテストしました。最大の入力長は約500Kトークンです。
表は、同社の社内テストで示された2つの入力長の結果です。1,024トークンのDecode速度は示されていません。
| 入力トークン数 | Prefill速度 | Decode速度 | 初回トークン出力までの時間 |
|---|---|---|---|
| 1,024 | 494.54 tokens/s | 記載なし | 2.22秒 |
| 499,712 | 628.91 tokens/s | 28.23 tokens/s | 795.77秒 |
同社の社内テストでは、4K、32K、128Kトークンなどのコンテキスト長でも、Decode速度は28〜33 tokens/sの範囲を維持しました。
結果はテスト時のハードウェア、ソフトウェア、モデル構成および推論設定に基づくもので、実際の性能は環境によって異なる場合があります。
想定される活用シーン
同社は、『GMKtec EVO-X5 Pro』の活用シーンとして、次の4つを挙げています。
- 研究・ドキュメント分析:大量の資料や長文コンテキストを使った情報分析
- ソフトウェア開発:ローカルLLMを使ったコード生成やコード分析
- AIモデルの検証:大規模言語モデルの動作検証や独自の推論環境の構築
- プライバシーを重視したAI活用:対応するAI処理をローカルで実行し、クラウド推論サービスへの依存を軽減
ローカル環境でAIを実行すると、データの管理方法や実行環境をより細かく制御できる可能性があるとのことです。実際のプライバシー保護は、使用するソフトウェアやネットワーク設定、外部サービスとの連携状況にも左右されます。
製品の詳細は、次のページで案内されています。