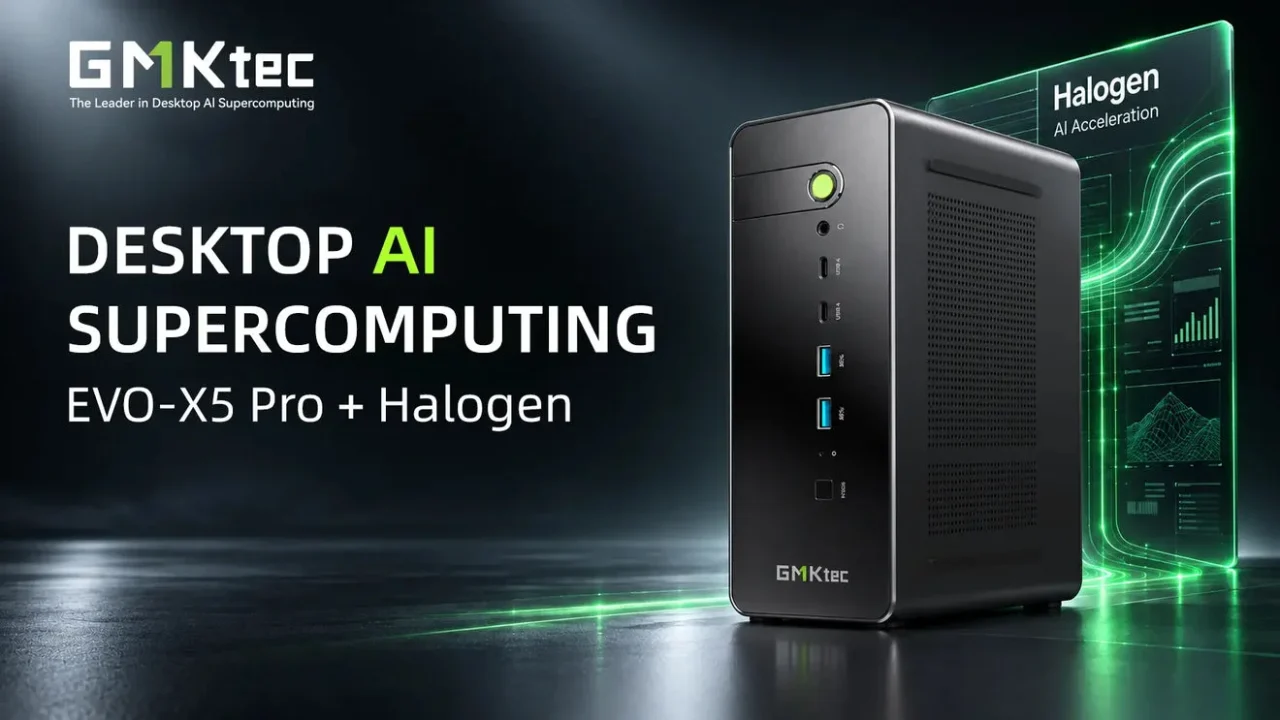
GMKtecは10月30日、『GMKtec EVO-X5 Pro』で使う専用推論エンジン『Halogen』の実測結果を公表しました。同社の社内検証では、『Halogen』が約75 tok/sの持続生成速度を記録し、汎用推論エンジンのllama.cppは約23 tok/sでした。
『Halogen』は、AMD Strix Halo向けに最適化された推論エンジンです。対象ハードウェアはGPUアーキテクチャ gfx1151、対象モデルは『Qwen3.8-Flash-Next』ファミリーです。ハードウェア固有のカーネルとモデル構造を考慮した実行処理を、最適化の方向性としています。
汎用推論エンジンには、NVIDIA、AMD、IntelなどのGPU環境や多様なモデルアーキテクチャへの対応が求められます。『Halogen』は対応するハードウェアとモデルを絞り込み、その環境での処理効率を優先する設計です。
チップそのものの改造や、物理的なメモリ帯域幅の変更は行われていません。今回の差はチップの変更ではなく、ソフトウェアの実装によるものだとのことです。
llama.cppとの生成速度比較
同社の社内検証では、『GMKtec EVO-X2』と『GMKtec EVO-X5 Pro』で『Qwen3.8-Flash-Next』を実行し、推論エンジンによる生成速度の違いを調べました。結果は次のとおりです。
- llama.cpp(汎用推論エンジン):約23 tok/s
- Halogen(EVO-X5 Pro):約75 tok/s
『Halogen』は、テスト条件下で約3.3倍の持続生成速度を記録しました。長いコンテキストを扱う場合には、条件によって差がさらに広がることもあるとのことです。
実際の性能は、モデルの設定、コンテキスト長、量子化方式、実行環境などによって異なります。
tok/sは「tokens per second」の略で、AIモデルが1秒間に生成するトークン数を示す指標です。
『Halogen』の最適化
『Halogen』の高速化は、カーネル、MoEモデルへの対応と量子化、投機的デコードの三つで構成されています。
ハードウェアに合わせたカーネル
『Halogen』は、gfx1151向けにカーネルを最適化しています。カーネルとは、GPU上で演算を実行するための処理プログラムです。AI推論ではこの処理がトークンの生成中に何度も実行されるため、個々の処理の効率が最終的な生成速度にも影響します。
演算リソース、メモリの使い方、キャッシュの特性を踏まえて処理全体を設計し、同じチップからより高い推論性能を引き出すことを目指しているとのことです。
MoEモデルへの対応と5.53 bpwの量子化
『Qwen3.8-Flash-Next』は、総パラメータ数が約1,800億(180B)のMoE(Mixture of Experts)型モデルです。MoEは、モデル内に複数の専門家(Expert)を配置し、入力に応じて必要な専門家を選択して処理するアーキテクチャです。
『Halogen』は対象モデルの実行パターンを考慮し、専門家のルーティングとデータ移動を最適化します。メモリへの負荷や処理のオーバーヘッドを抑えることを目指しているとのことです。
量子化設定には5.53 bpwを採用しています。bpw(bits per weight)は、モデルの各パラメータを保存するために使うビット数を示す指標です。一律に4bitへ圧縮するのではなく、メモリ効率とモデル品質のバランスを考慮した構成だとのことです。
投機的デコード
もうひとつの高速化技術が、投機的デコード(Speculative Decoding)です。通常の自己回帰型生成では、前のトークンをもとに次のトークンを一つずつ生成します。
投機的デコードでは、小さなドラフト用モデルや補助コンポーネントが複数の候補トークンを先行して生成し、メインモデルが候補をまとめて検証します。
同社の社内検証では、繰り返しの多いコンテンツ生成で最大94 tok/sを記録しました。特定の条件下でのピーク値で、すべてのタスクで同じ速度が得られるわけではありません。実際の効果は、モデルや入力内容、候補トークンの採用率などによって異なります。
入力処理から生成までの速度
最大192GBのユニファイドメモリを搭載する『GMKtec EVO-X5 Pro』と『Halogen』の組み合わせについて、同社は社内検証で次の結果を記録したとしています。
- 約75 tok/s:持続的なトークン生成速度
- 最大2,000 tok/s:プロンプト処理速度
- 最大94 tok/s:繰り返しの多いコンテンツ生成でのピーク速度
これらは異なる処理段階や条件における数値で、同じ指標として単純に比較できるものではありません。
LLMの推論は、2つの段階に分かれます。Prefill(プロンプト処理)は、入力された文章やコード、会話履歴をモデルが処理する段階です。Decode(トークン生成)は、入力内容をもとに回答を生成する段階です。
128Kトークンのコンテキストにも対応しています。言語や文章構成によって異なりますが、数百ページに相当する大量の情報を扱える規模です。
『GMKtec EVO-X5 Pro』の製品ページは次のとおりです。